Mit WSE-3 Turbo: Cerebras neues Rack-Scale-System hängt GPUs weiter ab

Ein Chip in der Größte eines kompletten Wafers: 2019 war das mit Cerebras erster Wafer-Scale-Engine (WSE) eine Sensation. Die dritte Generation des Konzepts nutzen mittlerweile Hochleistungsrechenzentren und KI-Unternehmen, AMD integriert sie in sein Helios-System und China hat das Konzept übernommen. Der Grund: Die Systeme erreichen deutlich höhere Tokenraten als GPUs.
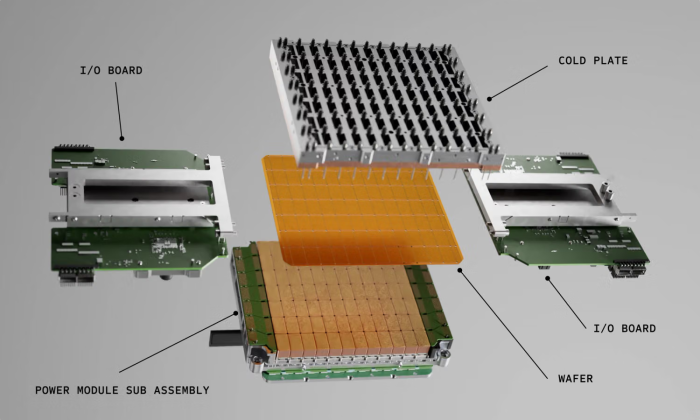
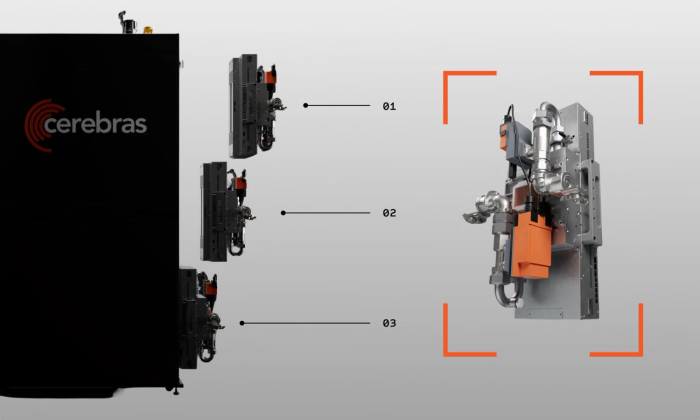
Mit dem neu vorgestellten Rack-Scale-System CS-4(öffnet im neuen Fenster) will Cerebras diesen Vorsprung weiter ausbauen. Es nutzt einen neuen Chip, noch größere Änderungen gibt es allerdings beim Rack-Aufbau. Cerebras hat ein neues Konzept für Energieversorgung, Vernetzung und Kühlung entwickelt. Die WSE-3 Turbo kommt als komplett anschlussfertiges Paket. Es umfasst Leistungs- und Steuerelektronik, Netzwerk sowie Direktwasserkühlung. Dank kompakterem Design passen drei der Wafer-Chips in ein 19-Zoll-Rack, beim CS-3 waren es noch zwei.
Kurios ist dabei der Aufbau: Die WSE-Einheiten werden vertikal an der Rückseite des Racks eingebaut. Die Vorderseite besteht rein aus modularen und redundanten Netzteilen – 42 Stück pro Chip.
Cerebras nennt das System Nexus; es soll halb so viele Komponenten wie der Vorgänger haben und schneller aufzubauen sein. Nexus soll auch für künftige WSE-Systeme verwendet werden, so dass Nutzer ihre Rechenzentren leicht durch Tausch einzelner Komponenten aktualisieren können. Cerebras will so schnellere Produktzyklen erreichen.
Mehr Leistung auf allen Ebenen
Auch wenn dessen Rahmendaten – 900.000 Prozessoren, 44 GByte SRAM, gefertigt in einem 5-nm-Prozess bei TSMC – gegenüber der WSE-3 unverändert sind, weist der neue Chip doch bedeutende Unterschiede auf.
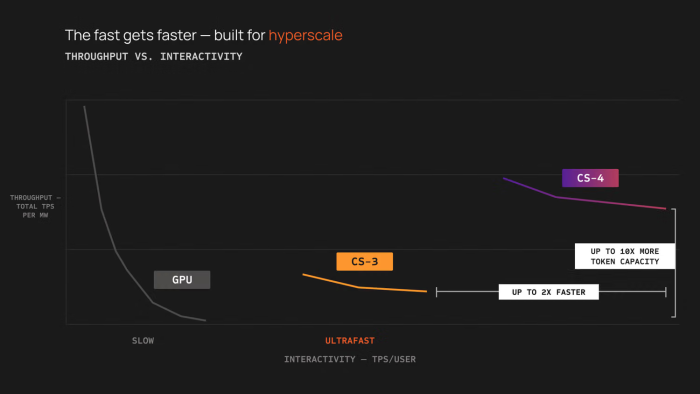
So ist die Speicherbandbreite mit 43,2 PByte/s mehr als doppelt so hoch wie bei der WSE-3. Die Bandbreite des Network-on-Chip hat Cerebras, wie auch die I/O-Bandbreite, exakt auf 53,5 PByte/s und 2,4 TBit/s verdoppelt.
Auch die Rechenleistung verdoppelt die WSE3-Turbo, dazu gibt es eine höhere Netzwerkbandbreite. Wie viele andere KI-Chips nutzt auch die WSE Remote Direct Memory Access over converged Ethernet (RoCE) für das Scale-out-Netzwerk. Zur Vernetzung innerhalb eines Racks (Scale-up) werden die drei Chips direkt verbunden. Alle Neuerungen zusammen sollen ermöglichen, selbst bei Modellen mit über 10 Billionen Parametern einen Durchsatz von über 1.000 Token/s zu erreichen. Cerebras verspricht dabei auch eine deutlich geringere Latenz als mit GPU-Systemen erreichbar. Auch bei der Effizienz soll CS-4 deutlich besser abschneiden.
Cerebras sieht bei CS-4-Systemen eine Trennung von Prompt-Verarbeitung (Prefill) und Token-Generierung (Decode) vor. Die WSE soll dabei lediglich den Decode-Prozess übernehmen. Der Prefill-Prozess hingegen soll auf anderer Hardware erfolgen, explizit genannt werden AMD-GPUs und AWS Trainium. Den gleichen Ansatz verfolgt Nvidia mit den zugekauften LPUs (g+).
Cerebras will erste CS-4-Systeme im laufenden dritten Quartal ausliefern.
Wir öffnen unsere neue Community für weitere Mitglieder! Möchtest du in konstruktiver und respektvoller Atmosphäre mit anderen IT-Experten über deine Themen sprechen? Sei dabei und melde dich an!
- Anzeige Hier geht es zu Künstliche Intelligenz: Wissensverarbeitung bei Amazon Wenn Sie auf diesen Link klicken und darüber einkaufen, erhält Golem eine kleine Provision. Dies ändert nichts am Preis der Artikel.