Leistungsfähigeres Front-End ermöglicht mehr Beschäftigung
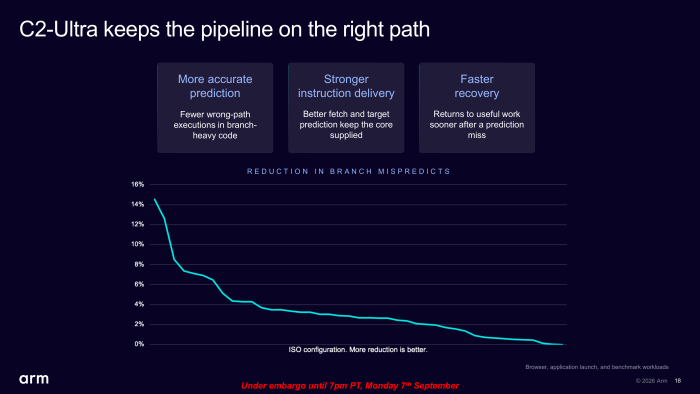
Daneben hat ARM einige Details der Mikroarchitektur verbessert. Die C2-Ultra-Kerne haben eine bessere Sprungvorhersage (g+) bekommen. In einigen Anwendungen soll die Anzahl falscher Vorhersagen um über zehn Prozent sinken.
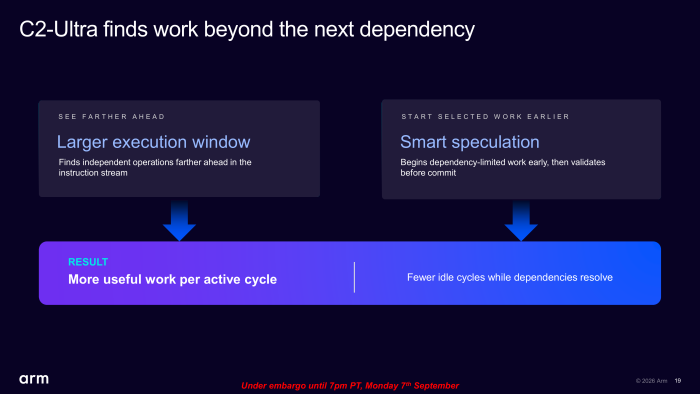
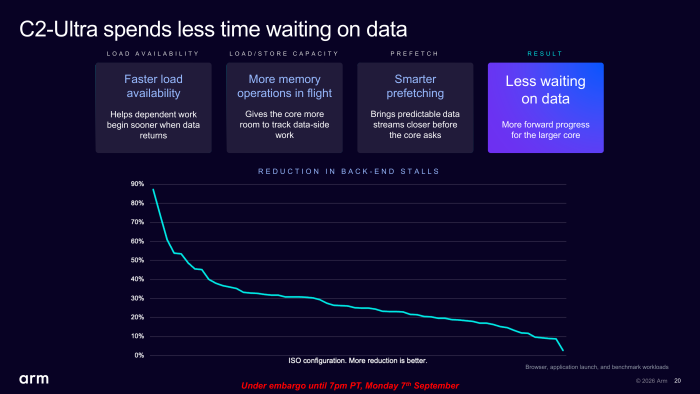
Zudem bekommen die Kerne ein größeres Out-of-Order-Fenster (g+) und sollen bei der spekulativen Code-Ausführung mehr Freiraum haben. Das soll bei einer breiten Anwendungspalette die Anzahl der Backend-Stalls, bei denen die Ausführungseinheiten unbeschäftigt sind, spürbar senken.
Auch die Speicheranbindung wird schneller
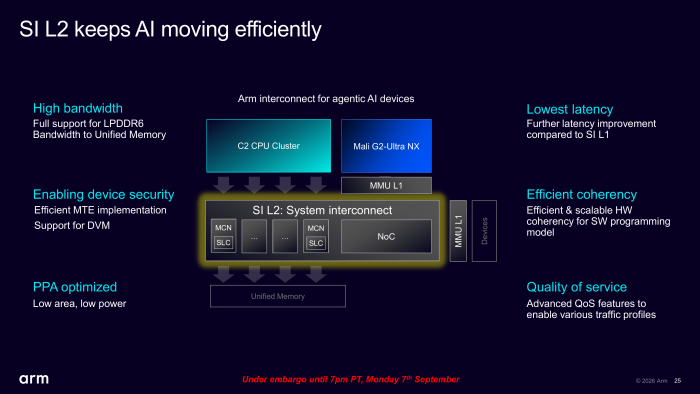
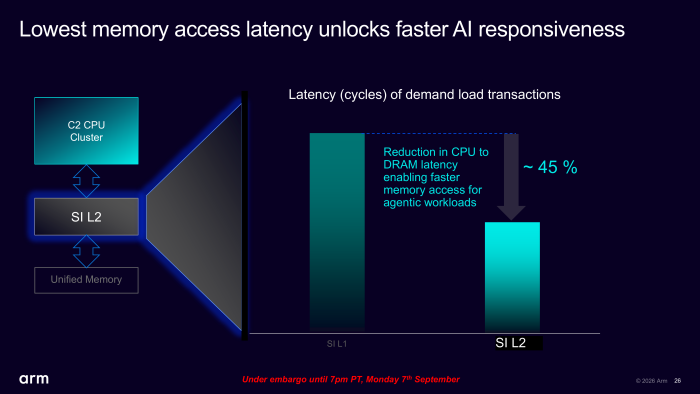
Bereits mit der ersten CSS-Generation hatte ARM eine neue Architektur für die Speicheranbindung (System Interconnect, SI) vorgestellt. Dieses entwickelte ARM weiter, es soll SI L2 niedrigere Latenzen bieten. Versprochen werden bis zu 45 Prozent niedrigere Speicherzugriffszeiten.
Allerdings schränkt ARM das Szenario auf KI-Agenten ein. Möglich ist, dass ein großer Teil der Zeitersparnis besseren Prefetchern zu verdanken ist, von denen andere Anwendungen nicht in gleichem Maße profitieren. Wieder kombiniert ARM die einzelnen Speicherkanäle mit einem Teil des SLC. Der fasst beim Referenzsystem mit vier 24 Bit breiten LPDDR6-Kanälen mit 12.800 MT/s 16 MByte und wird von CPU, GPU und anderen an das SI angebundenen Geräten geteilt.
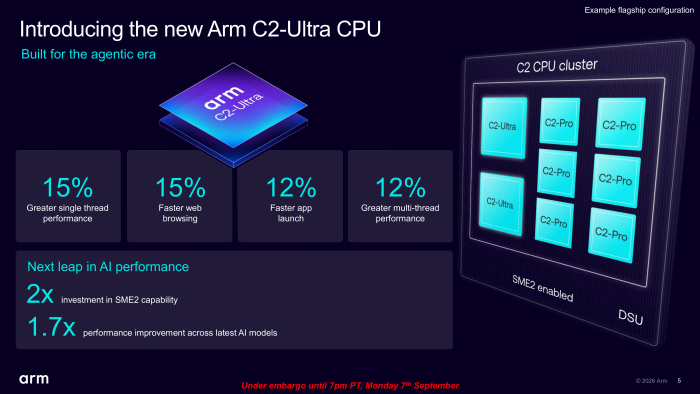
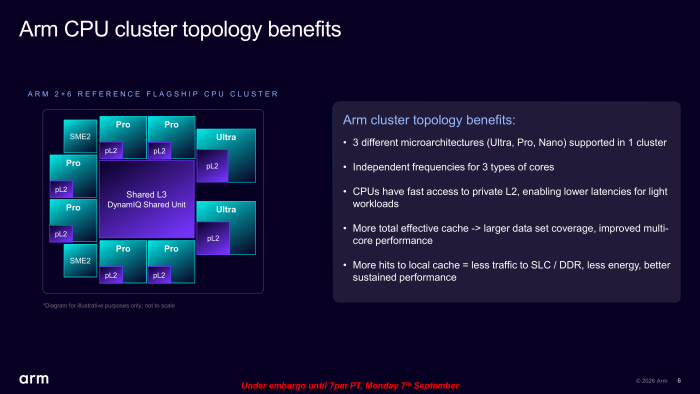
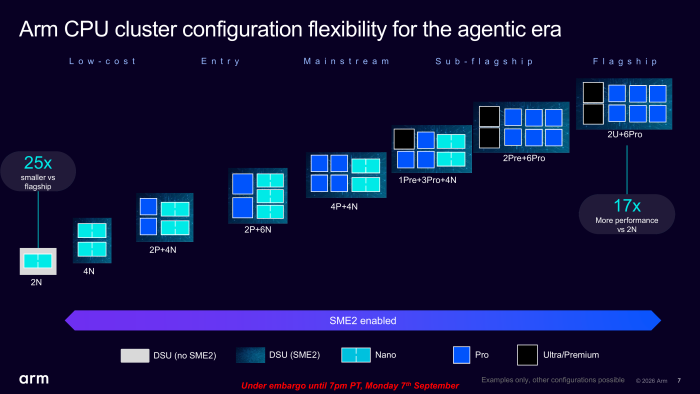
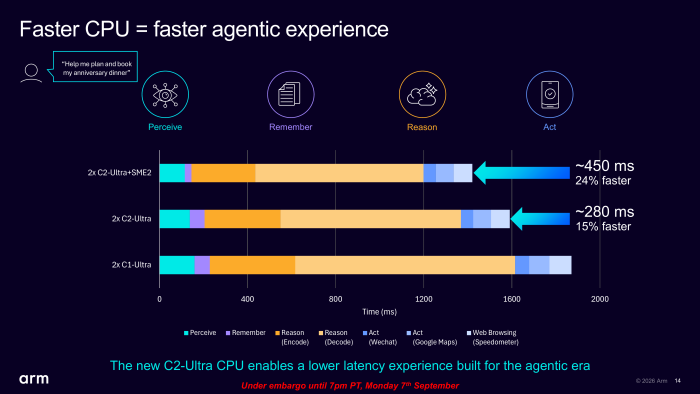
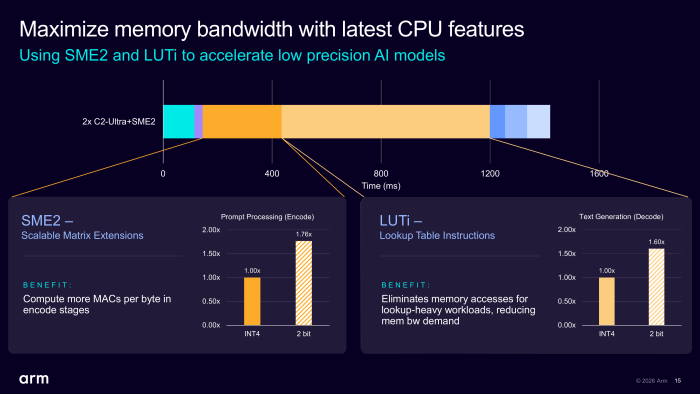
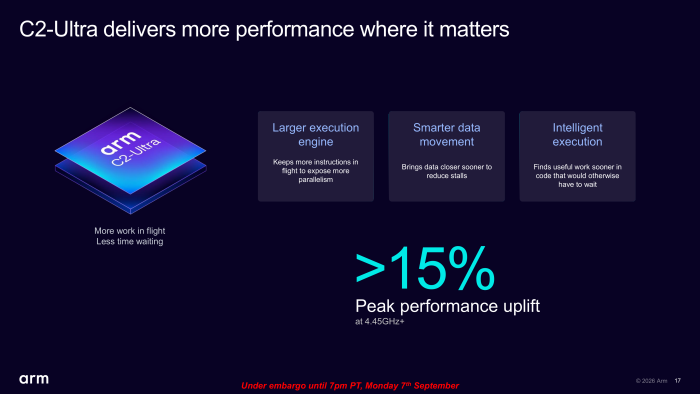
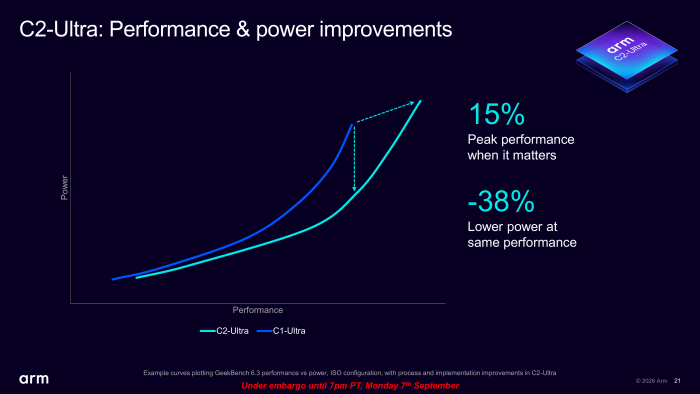
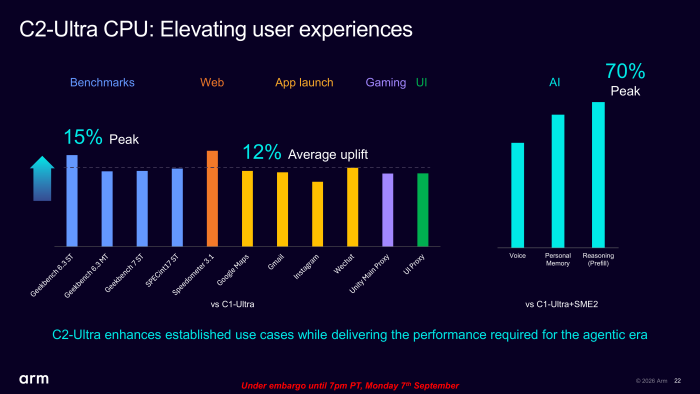
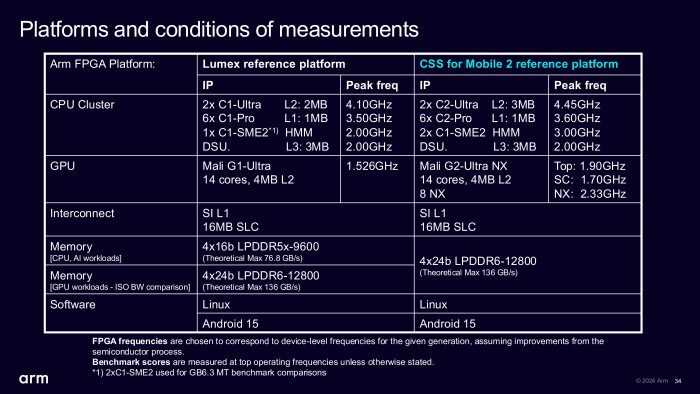
Zum Fertigungsprozess äußerte sich ARM nicht explizit, CSS for Mobile 2 dürfte aber für 2-nm-Prozesse ausgelegt sein.
- Anzeige Hier geht es zu Künstliche Intelligenz: Wissensverarbeitung bei Amazon Wenn Sie auf diesen Link klicken und darüber einkaufen, erhält Golem eine kleine Provision. Dies ändert nichts am Preis der Artikel.